دبلومة التعلّم المعزز
Reinforcement Learning Diplomaمن صياغة المشكلة رياضيًا إلى PPO و Actor-Critic
تبدأ من المفاهيم الأساسية وصياغة مشكلة التعلّم المعزز رياضيًا (Markov Decision Process)، ثم تنتقل إلى أشهر الخوارزميات مثل Temporal Difference و Policy Gradient و Actor-Critic، مع تطبيقات عملية باستخدام PyTorch.

Staff ML Engineer, General Motors
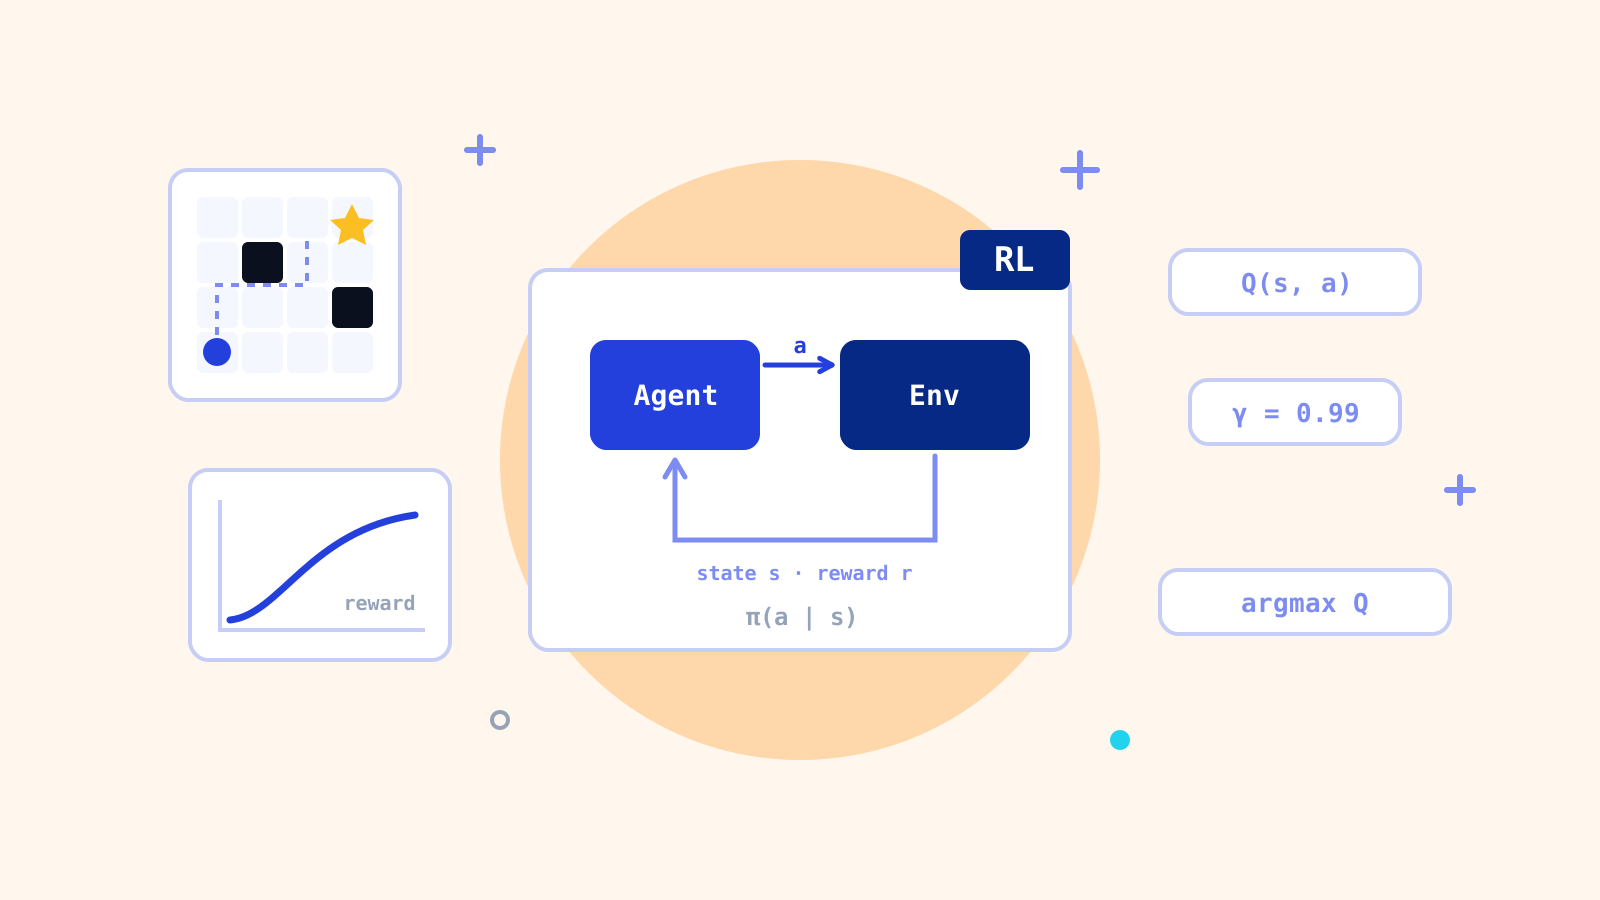
ماذا ستتعلم
- تفهم أساسيات التعلّم المعزز وموقعه من الذكاء الاصطناعي وتعلّم الآلة.
- تصوغ المشكلة رياضيًا كعملية قرار ماركوف (MDP) وتحلّها بـ Policy Iteration.
- تطبّق Q-Learning و Deep Q-Learning.
- تبني خوارزميات Policy Gradient و PPO و Actor-Critic و Soft Actor-Critic.
- تدرّب وكلاء أذكياء (Agents) يتخذون القرار من خلال التجربة باستخدام PyTorch.
- تتعرّف على Offline RL و Imitation Learning و Model-based RL.
- تفهم كيف يُستخدم التعلّم المعزز في تدريب النماذج اللغوية الكبيرة (RL for LLMs).
- تستعد للمستويات المتقدمة والبحثية في الذكاء الاصطناعي.
طلاب تعلّموا معنا يعملون اليوم في
أسماء موثّقة بموافقة أصحابها. لا نقدّم وعودًا وظيفية.
د. أحمد حفني
مهندس تعلّم آلة (Staff ML Engineer) في فريق القيادة الذاتية لدى General Motors، وحاصل على الدكتوراه من جامعة كارنيجي ميلون (Carnegie Mellon University)، ويمتلك خبرة عملية في تطوير أنظمة الذكاء الاصطناعي للقيادة الذاتية والروبوتات.
- يجمع بين الجانب الأكاديمي والتطبيق العملي
- يشرح بالتدريج من الأساسيات حتى المفاهيم المتقدمة
- تطبيقات واقعية من الروبوتات وأنظمة التوصية والقيادة الذاتية
المنهج الكامل: 4 وحدات
تشرح الدبلومة كل خوارزمية مع تطبيق عملي لها. محاضرتان مجانيتان لتحكم على الشرح قبل أن تقرّر.
01Foundations of Reinforcement Learning4 محاضرة
02Foundations of Reinforcement Learning II5 محاضرة
03Model-Free Online Deep Reinforcement Learning8 محاضرة
04Applications and Advanced Topics8 محاضرة
ما تخرج به من هذه الدبلومة
الأدوات
المفاهيم
المتطلبات السابقة
Python، وأساسيات تعلّم الآلة والشبكات العصبية، والاحتمالات والإحصاء، والجبر الخطي والتفاضل، والتعامل مع PyTorch.
لماذا CSkilled بدل المصادر المتفرقة؟
مقارنة بين التعلّم من مصادر متفرقة، والتعلّم من منهج واحد متكامل.
المصادر المتفرقة (يوتيوب / دورات عامة / معسكرات)
- العمق والمنهج: محتوى موزّع بلا ترتيب واضح، فتضيع بين المستويات.
- الممارسة: مسائل قليلة وغالبًا بلا حلول مشروحة، ومشاريع صغيرة غير مكتملة.
- المدرّس واللغة: مستوى شرح متفاوت، وكثير منها بالإنجليزية فقط.
- الدعم والتكلفة: بلا توجيه، وباشتراكات بالدولار أو معسكرات مرتفعة التكلفة.
ماذا تحصل عليه في أكاديمية CSkilled؟
- العمق والمنهج: 23 محاضرة و38 ساعة في 4 وحدات مرتّبة، تشرح الفكرة قبل استخدام أي أداة جاهزة.
- الممارسة والمشاريع: مسائل مصحّحة بحلول مشروحة، ومشاريع تطبيقية تجمع ما تعلّمته في عمل متكامل.
- المدرّس واللغة: شرح بالعربية مع المصطلح الإنجليزي، ويقدّمه د. أحمد حفني، الحاصل على الدكتوراه من Carnegie Mellon.
- الدعم والسداد: فريق دعم يجيب عن أسئلتك على واتساب، وتقسيط بدون فوائد حتى 3 أشهر.
تجارب حقيقية من طلاب أكملوا الرحلة
23 محاضرة · 38 ساعة
اختر خطة السداد التي تناسبك
بدون فوائد وبدون رسوم خفية. الرقم الكبير هو ما تدفعه اليوم.
السداد الكامل
تقسيط 3 أشهر
التقسيط متاح حاليًا بالجنيه المصري فقط. للاستفسار عن التقسيط بالدولار تواصل معنا.
الدفعة المقدّمة عند الاشتراك، ثم الأقساط كل 30 يومًا. بدون فوائد وبدون غرامات تأخير، ويتوقف الوصول مؤقتًا إذا لم يصل القسط خلال 3 أيام من موعده.
ابدأ بالمحاضرات المجانية اليوم
دبلومة التعلّم المعزز: 23 محاضرة و38 ساعة، تبدأ مجانًا وبدون بيانات دفع.
أسئلة قبل الاشتراك
ما المتطلبات السابقة لهذه الدبلومة؟
Python وأساسيات تعلّم الآلة والشبكات العصبية، مع الاحتمالات والجبر الخطي والتفاضل. إن لم تكن جاهزًا فابدأ بدبلومة تعلّم الآلة.
كم ساعة أحتاج أسبوعيًا؟
من 6 إلى 8 ساعات أسبوعيًا تكفي للتقدّم بثبات. الدراسة ذاتية الإيقاع ويمكن التوفيق بينها وبين الدراسة أو العمل.
هل المحاضرات مسجّلة؟
نعم، مسجّلة بالكامل وتشاهدها في الوقت الذي يناسبك.
ما مدة صلاحية الوصول إلى المحتوى؟
وصول مدى الحياة (Lifetime Access): تشاهد المحتوى في أي وقت دون مدة صلاحية، مع أي تحديثات أو إضافات جديدة للمحتوى مجانًا.
هل أحصل على شهادة؟
نعم، تحصل على شهادة إتمام صادرة من CSkilled وموقّعة من د. مصطفى سعد.
ما طرق السداد المتاحة؟
إنستاباي وفوري والبطاقات البنكية، مع تقسيط حتى 3 أشهر بدون فوائد.
لماذا الشرح بالعربية والمصطلحات بالإنجليزية؟
لتفهم الفكرة بلغتك، وتتعامل مع المراجع وسوق العمل بمصطلحاته.